
Cómo gastar menos tokens de IA: un 42 % menos por mensaje en el chat principal de Claude Code
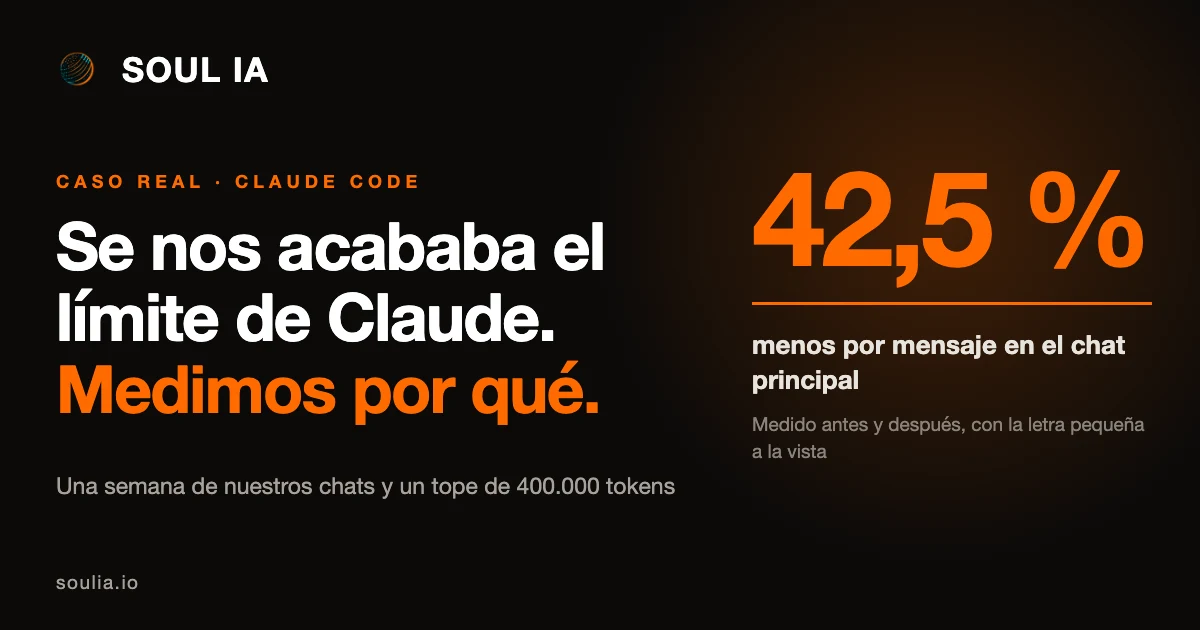
Cada vez que le mandas un mensaje a Claude Code, vuelve a leer la conversación entera. También el de una línea, si el chat lleva todo el día abierto. Eso es lo que hace que una conversación larga gaste tantos tokens, y por eso la palanca más grande para gastar menos no es escribir menos, sino decidir cuándo se cierra una conversación. En este artículo contamos qué medimos en nuestros propios chats, qué ajuste hicimos y cuánto nos ahorró: un 42,5 % menos por mensaje en el chat principal y un 30,6 % menos contando todos los chats, medido antes y después y sin prueba A/B. Con la tabla, el coste de compactar y todo lo que todavía no sabemos.
Esto no es una guía genérica ni un benchmark: es un estudio concreto nuestro, hecho con el uso real de Claude Code en Soul IA durante una semana (47 chats, más de 4.000 mensajes). Las cifras son las que medimos, y la letra pequeña va junto a ellas.
El 71 % del gasto salía de chats eternos
Parte del gasto según los tokens que arrastra cada mensaje. Medición propia: 47 chats y más de 4.000 mensajes. La letra pequeña, más abajo.
El paso a paso, en seis movimientos
- Vimos el síntoma. El 2 de octubre llegamos al 77 % de la ventana de cinco horas de nuestro plan, sin saber por qué.
- Construimos un medidor propio. Un script que lee las transcripciones locales de Claude Code y calcula el gasto de cada mensaje.
- Medimos una semana, sin tocar nada. Del 29 de septiembre al 5 de octubre: 47 chats y 4.066 mensajes, repartidos por el tamaño de la conversación que cada mensaje arrastraba.
- Encontramos dónde se iba. El 71 % del gasto del chat principal salía de mensajes con más de 400.000 tokens de conversación detrás.
- Pusimos un tope. Que Claude resuma la conversación al llegar a 400.000 tokens en vez de esperar a casi un millón, y montamos alrededor un sistema para que el resumen no pierda lo importante.
- Lo comprobamos de dos formas. Una simulación sobre los compactados reales y una comparación del antes y el después. Y apuntamos todo lo que no sabemos.
Por qué una conversación larga gasta tantos tokens
Un token es un trozo de texto, una palabra o parte de una palabra, que el modelo lee o escribe. El gasto se mide en tokens, y lo que no se ve a simple vista es que el modelo no recuerda la conversación: se la reenvían entera con cada petición.
La documentación oficial de Claude Code lo dice sin rodeos: el coste crece con el tamaño del contexto, y una pregunta de una línea en una sesión abierta todo el día consume por toda la conversación. La caché de prompts abarata esa relectura, pero no la elimina. Y si te paras más tiempo del que dura la caché (una hora en una suscripción), el primer mensaje al volver reprocesa todo otra vez.
Hay un coste fijo previo. En nuestro entorno, un chat nuevo ya arrancaba en unos 71.000 tokens (herramientas, skills, memoria y prompt de sistema) antes de escribir una sola palabra. Medido el 5 de octubre; cada configuración es distinta.
Qué medimos antes de tocar nada
El 2 de octubre nos plantamos en el 77 % de la ventana de cinco horas de nuestro plan por lanzar muchas tareas a la vez. Ahí decidimos dejar de intuir y medir. Construimos un medidor propio que lee las transcripciones locales y el 5 de octubre analizamos la semana del 29 de septiembre al 5 de octubre: 47 chats y 4.066 mensajes en el hilo principal.
Una aclaración que importa para todo lo que sigue: medimos en unidades, no en tokens brutos ni en euros. Una unidad son millones de tokens ponderados por precio (leer de caché pesa 0,1; escribir en caché, 1,25 o 2; la salida del modelo, 5). Es una cuota estimada, útil para comparar nuestros chats entre sí, no una factura.
Así se repartió el gasto del hilo principal según el tamaño de la conversación que cada mensaje arrastraba:
| Contexto del mensaje | Parte del gasto | Mensajes |
|---|---|---|
| hasta 150.000 tokens | 4,9 % | 467 |
| de 150.000 a 250.000 | 8,2 % | 679 |
| de 250.000 a 400.000 | 15,8 % | 833 |
| de 400.000 a 600.000 | 29,6 % | 958 |
| más de 600.000 | 41,6 % | 1.129 |
Los mensajes con más de 400.000 tokens de conversación detrás sumaban el 71 % del gasto del hilo principal (el 55 % si se cuentan también los subagentes). Y no por escribir mucho: en ese gasto, el 54,6 % es releer la caché, el 35,0 % guardar en caché y solo el 10,4 % lo que escribe el modelo.
Había otro agujero: volver a un chat que llevaba más de una hora parado. En esa semana pasó 71 veces con más de 100.000 tokens reescritos en la caché, y se llevó el 21 % del gasto. El peor caso fue un solo mensaje que reescribió 850.000 tokens.
Los subagentes (los ayudantes que Claude Code lanza para tareas aparte) fueron otro 34 % del gasto total de esa semana. Empezaban limpios, pero cada uno acumula su propio contexto mientras trabaja.
Qué cambiamos: un tope al contexto, no menos trabajo
Por defecto, Claude Code con ventana de 1 millón compacta (resume la conversación vieja) hacia los 967.000 tokens. Nosotros pusimos el ajuste autoCompactWindow en 400.000. Como Claude Code deja un colchón de 33.000, en la práctica compacta hacia los 367.000. Después de compactar, el chat vuelve a unos 116.000 tokens (mediana medida) y sigue.
Dos aclaraciones para que no se repita un error que cometimos nosotros. Primero: 400.000 no es una recomendación de Anthropic. El 7 de octubre lo dimos por recomendado a partir de un resumen que no contrastamos con la fuente; el 16 lo corregimos. La documentación deja la ventana en automático y no propone ningún valor: 400.000 es una decisión nuestra de coste. Segundo: se aplica desde la configuración (settings.json), que Claude Code lee al arrancar una sesión; los chats que ya estaban abiertos no lo cogen solos.
Compactar tiene un riesgo real: el resumen pierde detalle. La documentación oficial lo reconoce, y la comunidad cuenta casos de reglas olvidadas tras un compactado. Por eso no cambiamos solo la cifra. Montamos alrededor un sistema que no gasta modelo: unas instrucciones para que el resumen sea de 12.000 caracteres como máximo y con secciones fijas (petición y reglas, decisiones, hallazgos, estado y siguiente paso), un registro mecánico que recupera de la propia transcripción los últimos mensajes, los ficheros tocados y los comandos, y un aviso cuando un chat ha compactado varias veces. La conversación completa sigue guardada en disco por si hay que buscar un detalle.
Cuánto ahorra: la tabla
Con los compactados reales de los 8,6 días con tope (del 7 de octubre a las 9:30 al 15 de octubre a las 22:45: 66 chats, 12.594 mensajes del hilo principal y 170 compactados), simulamos qué habría costado esa misma secuencia de mensajes con otros topes. Hay dos formas razonables de modelar el instante en que se compacta y no sabemos cuál se parece más a la realidad, así que calculamos las dos y damos el rango.
| Tope | Compactados por día activo | Espera por compactados, minutos al día | Gasto total frente a 400.000 | Ahorro frente a no poner tope |
|---|---|---|---|---|
| 300.000 | de 56 a 60 | de 46 a 50 | de 6,3 % a 6,6 % menos | de 34,8 % a 35,7 % |
| 400.000 (el nuestro) | de 32 a 34 | de 27 a 29 | 0 % | de 30,4 % a 31,2 % |
| 500.000 | de 22 a 23 | de 19 | de 7,1 % a 7,9 % más | de 25,5 % a 25,7 % |
| 600.000 | de 16 a 17 | de 14 | de 15,3 % a 16,2 % más | de 19,8 % a 20,0 % |
| 800.000 | de 10,6 a 10,8 | de 9 | de 30,3 % a 32,0 % más | de 9,1 % a 9,3 % |
| Sin tope (1 millón) | 7 | 6 | de 43,7 % a 45,3 % más | 0 % |
Día activo es un día con compactados (fueron 5 en la ventana). La espera sale de 50 segundos por compactado, la media que medimos.
La lectura: sin tope, la misma secuencia de mensajes habría costado un 44 % más. Con el tope de 400.000 ahorramos un 31 % del gasto total y un 34 o 35 % del hilo principal (en los subagentes, entre un 14 y un 15 %). Subir el tope a 500.000 cuesta entre un 7 y un 9 % más. Bajarlo a 300.000 ahorra solo un 6 o 7 % más, pero casi duplica los compactados, y cada compactado es una ocasión de perder detalle. Por eso elegimos 400.000: un compromiso razonable, no un óptimo demostrado.
Repetimos el cálculo el 20 de octubre sobre los mismos datos y salió lo mismo.
Lo que midió el antes y el después
La simulación calcula lo que habría pasado. Para ver lo que pasó comparamos la semana de antes (29 de septiembre al 7 de octubre) con los 8,6 días con tope:
- El mensaje medio del hilo principal pasó de 0,0803 a 0,0462 unidades: un 42,5 % menos, con el contexto medio bajando de 459.000 a 240.000 tokens.
- Contando todos los mensajes (también subagentes), de 0,0635 a 0,0441: un 30,6 % menos.
- Por día, el gasto total casi no cambió (de 91,5 a 87,4 unidades, un 4 % menos) y los mensajes subieron un 38 % (de 1.440 a 1.982 al día).
Esa última línea es la que importa: con casi el mismo gasto diario, hicimos bastantes más mensajes. Pero ojo con lo que no dice.
Lo que no sabemos, y por qué no ponemos un número más bonito
Hay números más redondos y más vistosos. Este es el que aguanta, y esta es su letra pequeña:
- No es una prueba A/B. El 7 de octubre no cambió solo el tope: también el reparto de trabajo, el uso de subagentes y las instrucciones de compactado. El antes y después no separa causas, y la diferencia entre el 42,5 % medido y el 34 % a 35 % simulado en el hilo principal puede ser mezcla de tareas. Tenemos diseñado un test A/B del tope (400.000 frente a 600.000, sorteado en cada punto de decisión), pero está en borrador y no lo hemos activado.
- No medimos calidad. Ni tareas terminadas, ni errores, ni esperas reales entre topes. Un mensaje más barato no es un trabajo mejor. El 38 % más de mensajes no es trabajo terminado: parte pueden ser relecturas tras compactar.
- Compactar cuesta. El propio compactado es entre el 5,2 % y el 5,5 % del gasto simulado. Tras un compactado con tope, el chat vuelve a leer en las 40 llamadas siguientes 1,16 ficheros ya leídos de media (frente a 0,33 en los puntos de control sin compactar), unos 3.000 tokens de más. Y cada compactado son unos 50 segundos de espera.
- Una sola persona, 8,6 días. Solo 32 de los 66 chats compactaron alguna vez, y los 10 con más compactados suman el 78 %. No lo extrapoles a tu equipo sin medir el tuyo.
- Cuota estimada, no tokens ni euros. Las unidades son un estimador nuestro, calibrado con lecturas exactas del uso, pero un estimador.
Si alguien te promete "un 90 % menos de tokens", pregunta con qué medida, en qué chats y qué pasó con el trabajo.
¿Lo arreglamos? Hasta dónde llegamos y hasta dónde no
Respuesta honesta: arreglamos una parte, y otra sigue abierta.
- Lo que sí arreglamos: cada mensaje cuesta bastante menos. Un 42,5 % menos en el chat principal y un 30,6 % contando todos los chats; la simulación apunta a un 31 %.
- Lo que el tope no arregla por sí solo: el gasto total por día casi no bajó (un 4 %). Lo que cambió es que con el mismo gasto hicimos un 38 % más de mensajes. Si tu objetivo es gastar menos en total, el tope no basta. Si es llegar menos veces al límite, hay que comprobar que ese 38 % más es trabajo útil, y eso todavía no lo hemos medido.
- Lo que sigue abierto: los subagentes fueron el 34 % del gasto y con el tope solo bajan entre un 14 y un 15 %. Volver a un chat tras más de una hora parado (el 21 % del gasto de esa semana) no lo ataca el tope y no lo hemos medido por separado.
- Lo que haría falta para darlo por cerrado: activar el test A/B del tope y medir si el trabajo sale igual de bien.
Otros hábitos que recomienda la documentación oficial
Estos no los hemos medido por separado y no les atribuimos ningún porcentaje; son los que describe la página oficial de costes de Claude Code:
- Limpiar entre tareas distintas con /clear. Es gratis, y el contexto viejo se paga en cada mensaje siguiente.
- Compactar con foco (/compact seguido de qué conservar) en los cortes naturales entre tareas, mejor que esperar al automático a mitad de una.
- Elegir el modelo según la tarea. Sonnet para la mayoría y Opus para lo que de verdad lo pide; los subagentes sencillos, con un modelo más pequeño.
- Mantener corto el CLAUDE.md (la guía recomienda menos de 200 líneas) y mover a skills lo que solo hace falta a veces.
- Desactivar los servidores MCP que no uses y delegar en subagentes las salidas enormes (tests, logs).
- Pedir cosas concretas. "Añade validación al login de auth.ts" gasta menos que "mejora el código".
- Parar pronto si va mal (Escape y /rewind) y usar el modo plan en lo complejo.
Preguntas frecuentes
¿Qué es un token?
Un trozo de texto, una palabra o parte de una palabra, que el modelo lee o escribe. El uso de un modelo de lenguaje se mide en tokens, de entrada y de salida.
¿Por qué gasta más tokens una conversación larga?
Porque en cada petición Claude Code envía la conversación entera. Con la caché de prompts esa relectura sale más barata, pero sigue contando contra tu uso. Y tras una pausa más larga que la caché, el primer mensaje reprocesa todo.
¿Compactar la conversación pierde información?
Sí, pierde detalle: salidas literales, instrucciones dichas solo de palabra, matices. No pierde lo que está en archivos que se recargan solos (CLAUDE.md, memoria) ni la transcripción, que sigue en disco. Lo que importa conviene tenerlo en esos archivos y no solo en la conversación.
¿Cuánto se puede ahorrar?
En nuestros chats, un 42,5 % menos por mensaje en el chat principal y un 30,6 % menos contando todos los chats, medido comparando antes y después; la simulación frente a no poner tope da un 31 %. Sin prueba A/B ni medida de calidad. Tu cifra dependerá de cómo trabajes; mide primero el tuyo.
¿Vale para ChatGPT u otros asistentes?
La mecánica de fondo, que cada turno vuelve a procesar el historial, es la de cualquier modelo de lenguaje usado por API. Pero nuestras cifras son de Claude Code y no las trasladamos a otras herramientas.
¿/clear o /compact?
/clear empieza de cero y no cuesta nada. /compact conserva un resumen, pero lee antes toda la conversación, así que compactar un contexto enorme es en sí una petición grande.
La regla que nos llevamos
El gasto en IA tiene un componente que no se ve en el dashboard y que se arregla con orden: cuánto arrastra cada conversación y cuándo se cierra. Nosotros lo medimos antes de tocar nada, y eso es lo que separa un ajuste que ahorra de uno que solo parece que ahorra. Si en tu empresa ya se usa IA a diario y nadie sabe de dónde sale el gasto, lo vemos sobre tu caso.
Si tu equipo usa IA a diario, puede que una parte grande de tu gasto salga de conversaciones eternas y no lo estés viendo. Lo hacemos contigo: medimos tu uso real, te decimos cuánto se te va en chats que no se cierran y montamos el tope y el sistema para no perder contexto al resumir. Cada semana que sigues igual, pagas por que la IA relea lo mismo otra vez.
Escrito por
Jorge Marín Pérez · Fundador de Soul IA
Ayudo a pymes a automatizar su atención al cliente y sus procesos con IA, desde Málaga. Lo que cuento en este blog sale de lo que montamos cada semana para negocios reales.
¿Quieres saber qué se puede automatizar en tu negocio?
Hablar con Soul IA